公交数据台
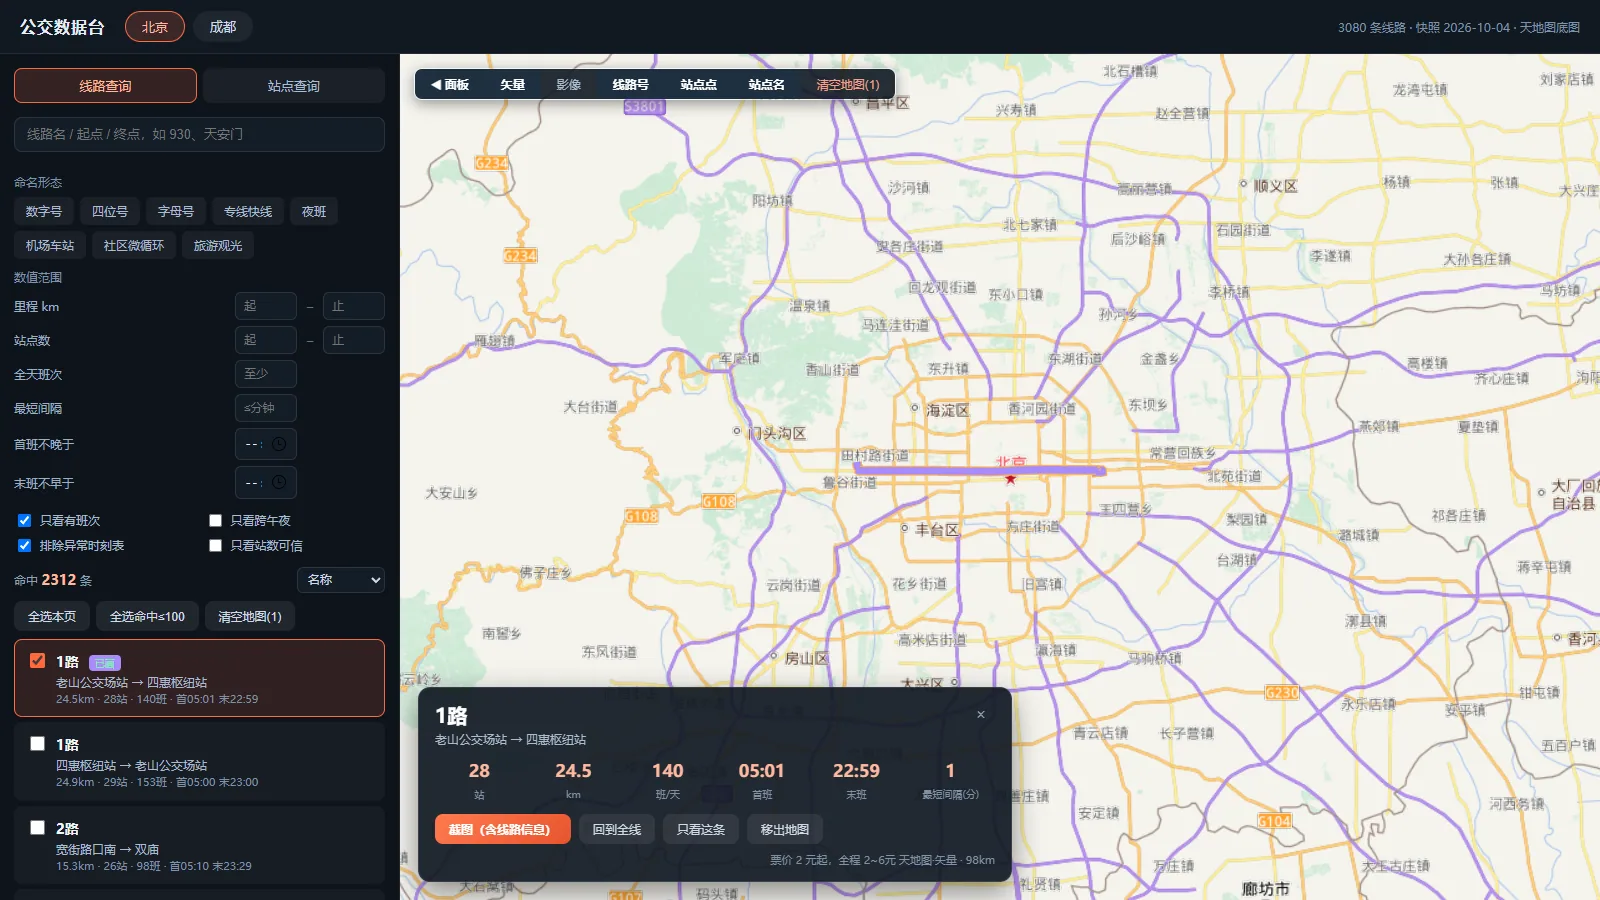
面向数据本身的工具:把 3000+ 条线路一次性叠到一张图上,按走廊、网格与行政区统计站点分布和线网密度。
- 技术栈
- Vue 3TypeScriptCesium天地图ViteNode.js
亮点
- 一次加载 3000+ 条线路仍可流畅缩放:单线与批量叠加走两套渲染分级,批量模式不画站点节点、几何并行预取后一次性绘制
- 线路配色按线路名哈希稳定分配 —— 同一条线在任何一次筛选结果里都是同一个颜色
- 站点与线路用 physicalStId 对齐,同名站点按坐标聚类,避免把相隔数公里的同名站合成一个点
- 底图使用天地图,数据口径与图面尺度对得上
这是什么
巴士大屏回答「车在哪」,公交数据台回答「线在哪、有多密」。
它是一个面向数据本身的工具 —— 更像一张可以交互的统计图,而不是给人看的产品画面。典型用法是把一批线路一次性叠到地图上,看看它们在某条街道或某个网格里到底有多少条重叠。
快照口径:3080 条线路,2026-10-04 的数据版本。
它要解决的具体问题
做可视化时最常被问到的一类问题是:
这条路上到底有多少条公交线?某片区站点的平均间距是多少?
用真正的 GIS 工具当然也能算,但每次都要配环境、写脚本、导数据。数据台的目标是把这类问题缩短到「几次点击」:选一批线路 → 叠加 → 看密度 → 读数。
关键设计
渲染分级(这是性能的关键)。 单条线路和上百条线路叠加,对渲染的要求完全不同:
- 单线模式:完整表现 —— 发光路径、站点节点、站名标签、走廊高亮。这时候细节比流畅重要。
- 批量叠加模式:一律走轻量渲染 —— 不画站点节点、不画标签,只保留线几何与配色。几何并行预取、一次性绘制,避免逐条线路异步加载造成的连续重绘。
如果批量模式也照单线渲染来画,几千个站点节点加几千个标签会把帧率直接打到个位数。这条分级是刻意保留的,不是临时优化。
配色要稳定。 线路颜色由线路原始名称的哈希决定。好处是:同一条线路,无论这次筛选出了哪些线、顺序如何,颜色永远一致 —— 看图的人可以形成稳定的视觉记忆。如果按索引分配颜色,换一次筛选条件整张图就变了。
站点的对齐口径。 线路数据不直接内嵌站点几何,而是通过站点 ID 引用;同一物理站台在不同方向上可能有多条记录。所以:
- 线路的
stop_ids(顺序即站序)与站点表的physicalStId对齐; - 同名站点必须按坐标聚类,否则会把相距几公里的同名站合并成一个点,走廊统计全错。
为什么底图用天地图。 工具图对图面准确性和合规性都敏感,天地图作为国家地理信息公共服务平台,在数据口径与审图合规上都更站得住。
边界与不足
- 内部工具定位:没有账号体系、没有多用户,数据版本靠快照文件管理。
- 不做路径规划。它统计线网,不做最短路径与换乘方案 —— 那是另一个问题的解。
- 站点表完整度依赖数据源。上海等城市的线路 JSON 完整,但站点表下载尚未完成,因此暂不计入统计口径。
一点实现上的取舍
这个工具的界面代码刻意放在主工程 src/ 之外,用独立的构建入口打包。
原因是它和主产品共用 Cesium 与数据层,但类型检查、构建产物、发布节奏完全不同 —— 放在一起会让主工程的类型检查被迫感知一堆只在工具里用到的依赖。物理隔开之后,两边可以各自演进,互不拖累。